- Litt om store språkmodeller
- Problemet med hallusinering
- Tre godkjente KI-verktøy
- Noen gode råd
- Kilder / Videre lesning
1. Litt om store språkmodeller
KI-verktøyene vi skal gjennomgå i denne leksjonen har til felles at de bygger på store språkmodeller. En stor språkmodell (LLM) er et nevralt nettverk som er trent på enorme mengder tekst fra bøker, artikler, nettsider på det åpne nettet, og andre tekstkilder utviklerne har fått tilgang på. Under treningen lærer modellen å forutsi hvilke ord som sannsynligvis kommer etter hverandre i en setning.
Chat med en chatbot
Språkmodellene fungerer som en chatbot. Du skriver en instruks ("prompt") i tekstboksen, og så genererer modellen et svar med utgangspunkt i ordene i instruksen og treningsmaterialet den har trent på. Merk deg at tekstsvaret som blir generert er basert på en sannsynlighetsberegning gjort ut fra tilgjengelige data, og ikke en sammenstilling av kvalitetssikret informasjon.
Det betyr modellene kan generere relativt gode tekster om avklarte problemstillinger som er mye omtalt i treningsmaterialet, men mindre gode tekster om uavklarte problemstillinger som er mindre omtalt. Det betyr også at modellene også kan generere svar fulle av hallusinasjoner. Mer om det lenger ned i teksten.
Hvis du ikke er fornøyd med svaret modellen gir kan du gi mer informasjon eller spesifisere hva du ønsker i en ny instruks. Verktøyet generer da et svar basert på det nye instruksen i kontekst av den forutgående samtalen.
RAG-teknologi
Noen språkmodeller er forsterket med såkalt RAG-teknologi. RAG står for "Retriveal-Augmented Generation". Når en slik modell mottar en instruks vil den først søke på instruksen, som en søkemotor, og hente inn relevante dokumenter ("retrieval"). Derette vil den generere et svar med utgangspunkt i dokumentene den har funnet i tillegg til treningsmaterialet den på forhånd har trent på ("generation")
Det gjør at slike modeller kan generere mer oppdaterte og kontekstavhengige tekster enn det "vanlige" språkmodeller gjør. Mange gir også kildehenvisninger til svarene, slik at du kan sjekke hvor informasjonen kommer fra.
Merk deg at ulike RAG-modeller er programmert til ulike søkeomfang. For eksempel er CoPilot programmert søke etter dokumenter på det åpne nettet, mens KI-søket i Lovdata Pro 2 er avgrenset til å søke i rettskilder i Lovdatas egne baser.
2. Problemet med hallusinering
Alle store språkmodeller kan hallusinere. Det betyr at de kan finne opp informasjon som virker troverdig og tilsynelatende er sann, men som egentlig er uten rot i faktiske forhold. Årsaken er at store språkmodeller genererer svar basert på sannsynlighetsberegning og ikke fakta.
En amerikansk studie fra 2024 viste at ChatGPT (GPT-4) hallusinerte i 58 prosent av tilfellene. Dette er åpenbart problematisk i situasjoner hvor det er avgjørende å levere riktig informasjon, som f.eks. en rettssak.
Det har vært mange eksempler på jurister som har levert dokumenter med kilder oppdiktet av KI-verktøy. Et tilfelle involverte Michael Cohen, den tidligere avdokaten til president Donald Trump, som leverte inn et prosesskriv med oppdiktede kilder til en ankedomstol i New York.
Også i Norge har vi eksempler på dette. I april ble det kjent at en advokat hadde levert et prosesskriv med KI-generert informasjon til Høyesterett. Skrivet inneholdt sitater som var oppdiktet og henvisninger til rettskilder som ikke eksisterte.
På bakgrunn av denne hendelsen oppdaterte Høyesterett sin advokatveiledning med et eget punkt om bruk av KI-verktøy (se punkt 19).
Også nyere språkmodeller hallusinerer
Problemet med hallusinering gjelder også for nyere språkmodeller forsterket med RAG-teknologi. Dette kom tydelig frem i en amerikansk studie fra 2025.
I studien testet forskerne graden av hallusinering i KI-verktøy brukt av amerikanske jurister. Først utviklet forskerne et sett med 200 juridiske spørsmål. Deretter testet de spørsmålene på tre jurdiske KI-verktøy (fra henholdsvis LexisNexis, Westlaw og Thomson Reuters) og et generelt KI-verktøy (ChatGPT). Svarene ble så manuelt vurdert for korrekthet, i hvilken grad de hadde grunnlag i kilder, og hallusinasjoner.
- Lexis+ AI (LexisNexis) leverte nøyaktige svar i 65 prosent av tilfellene. Den hallusinerte i 17 prosent av tilfellene.
- AI-Assisted Research (WestLaw) leverte nøyaktige svar i 42 prosent av tilfelllene. Den hallusinerte i 33 prosent av tilfellene.
- Ask Practical Law AI (Thomson Reuters) leverte nøyaktige svar i 20 prosent av tilfellene. Den hallusinerte i 17 prosent av tilfellene.
- ChatGPT leverte nøyaktige svar i 49 prosent av tilfellene. Den hallusinerte i 34 prosent av tilfellene.
Det er imponerende at Lexis+ AI svarte riktig i så mye som 65 prosent av tilfellene. Problemet at det er vanskelig å vite når modellen svarer riktig og når den svarer feil, for den svarer like overbevisende i begge tilfeller.
3. Tre godkjente KI-verktøy
Det er en rekke juridiske og etiske utfordringer ved bruk av KI-verktøy. Vi anbefaler derfor at du kun bruker verktøy som er godkjent av UiO, slik som GPT UiO og Microsoft CoPilot. Du kan også bruke KI-søket i Lovdata Pro 2. I det følgende ser vi nærmere på disse tre verktøyene.
GPT UiO
GPT UIO er kort fortalt UiOs personverntrygge utgave av ChatGPT. Alle data blir lagret på UiOs servere og navnet ditt og andre personopplysninger blir ikke utlevert til andre.
GPT UiO bygger på en "vanlig" stor språkmodell (GPT-4). Når du skriver inn en instruks vil modellen generere et svar med utgangspunkt i instruksen og treningsmaterialet den har trent på. Modellen kan generere overbevisende tekster om det meste, inkludert juridiske spørsmål. Det er viktig å huske at svarene modellen genererer er basert på en sannsynlighetsberegning med utgangspunkt i treningsmaterialet og ikke anvendelse av juridisk metode.
Hvor mye har ChatGPt trent på norsk rett? I artikkelen "ChatGPT og juridiske tekster" undersøkte Hans Christian Farsethås hva slags tekster om norsk rett som GPT-3 hadde trent på. Han fant ut at treningsgrunnlaget hovedsakelig bestod av nettsteder på det åpne nettet. De tre mest besøkte nettstedene var Stortinget.no, Regjeringen.no og gratisversjonen av Lovdata. Vi vet ikke hva som er treningsgrunnlaget for GPT-4, som GPT UIO baserer seg på, men det er antagelig noe av det samme.
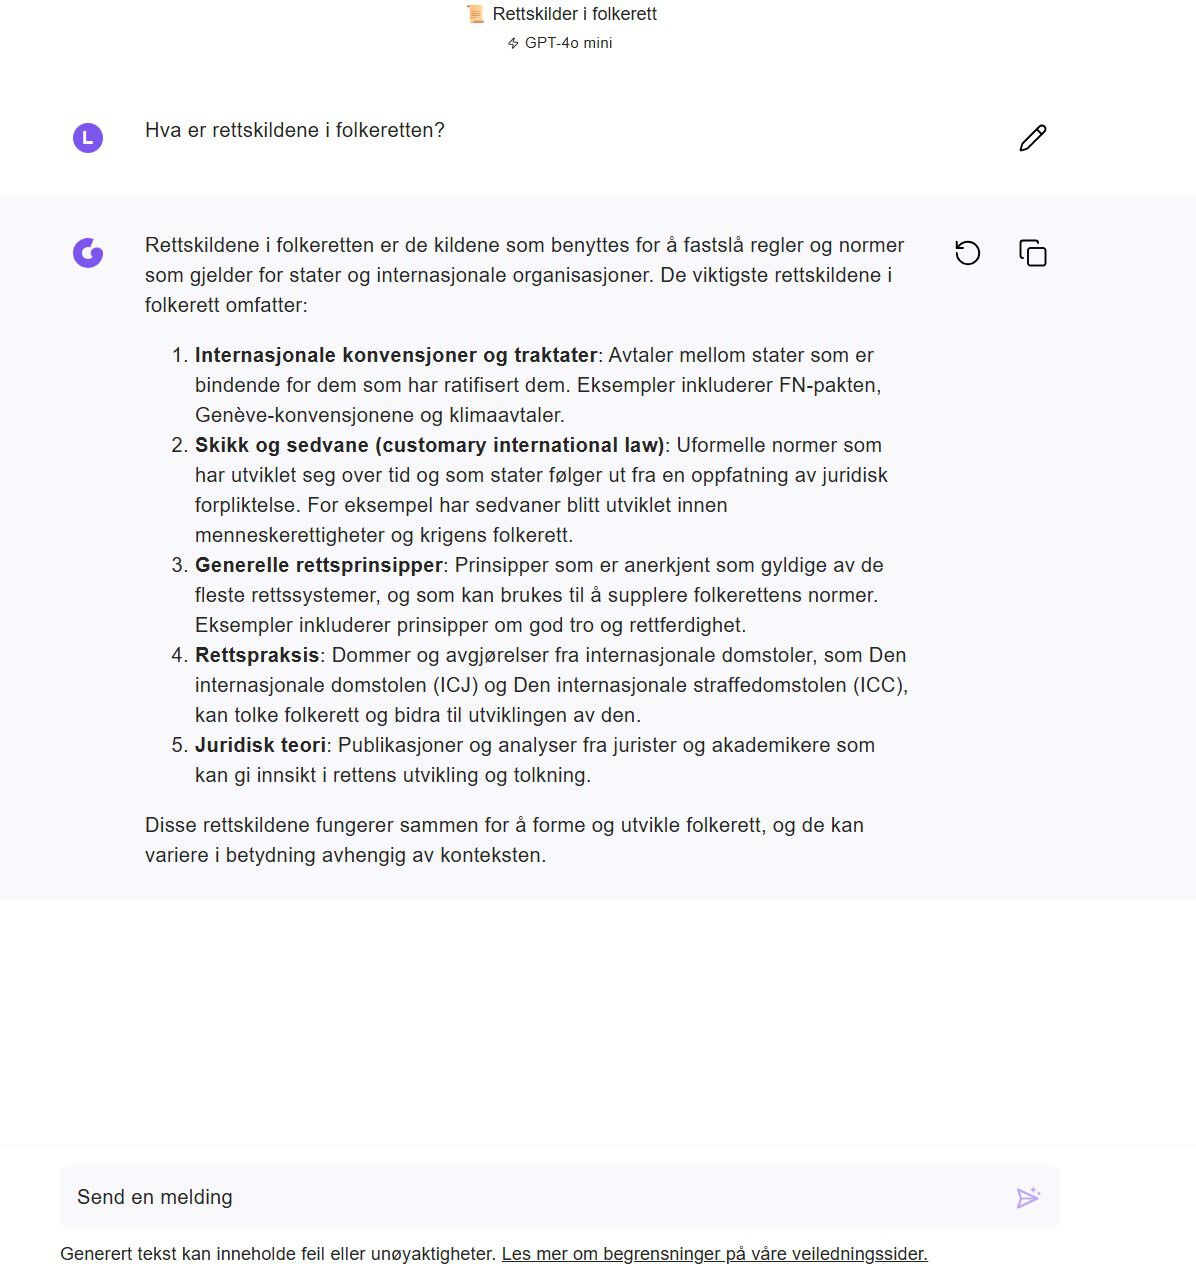
ChatGPT har antagelig trent mer på folkerett og menneskerettigheter, rett og slett fordi finnes mye mer tekst om disse områdene på det åpne nettet. Det er likevel ingen garanti for at modellen genererer gode svar på spørsmål rettet mot disse områdene. Da vi spurte UiO GPT "Hva er rettskildene i folkeretten?" genererte den et kort og lite utfyllende svar, som heller ikke har noen kildehenvisninger.
CoPilot
CoPilot er Microsofts "intelligente kontorassistent". Verktøyet kan hjelpe deg med oppgaver som å skrive utkast til et brev, oppsummere dokumenter, og gjøre enkel research. Stadig flere norske virksomheter tar i bruk Copilot, inkludert universiteter, offentlige virksomheter, domstoler, og advokatfirmaer.
CoPilot bygger på en RAG-modell. Det betyr at modellen vil først søke etter relevante dokumenter på det åpne nettet samt i dokumenter du har lagret i Office 365. Modellen vil deretter generere et svar basert på dokumentene den har hentet inn, med klikkbare lenker til dokumentene den har brukt.
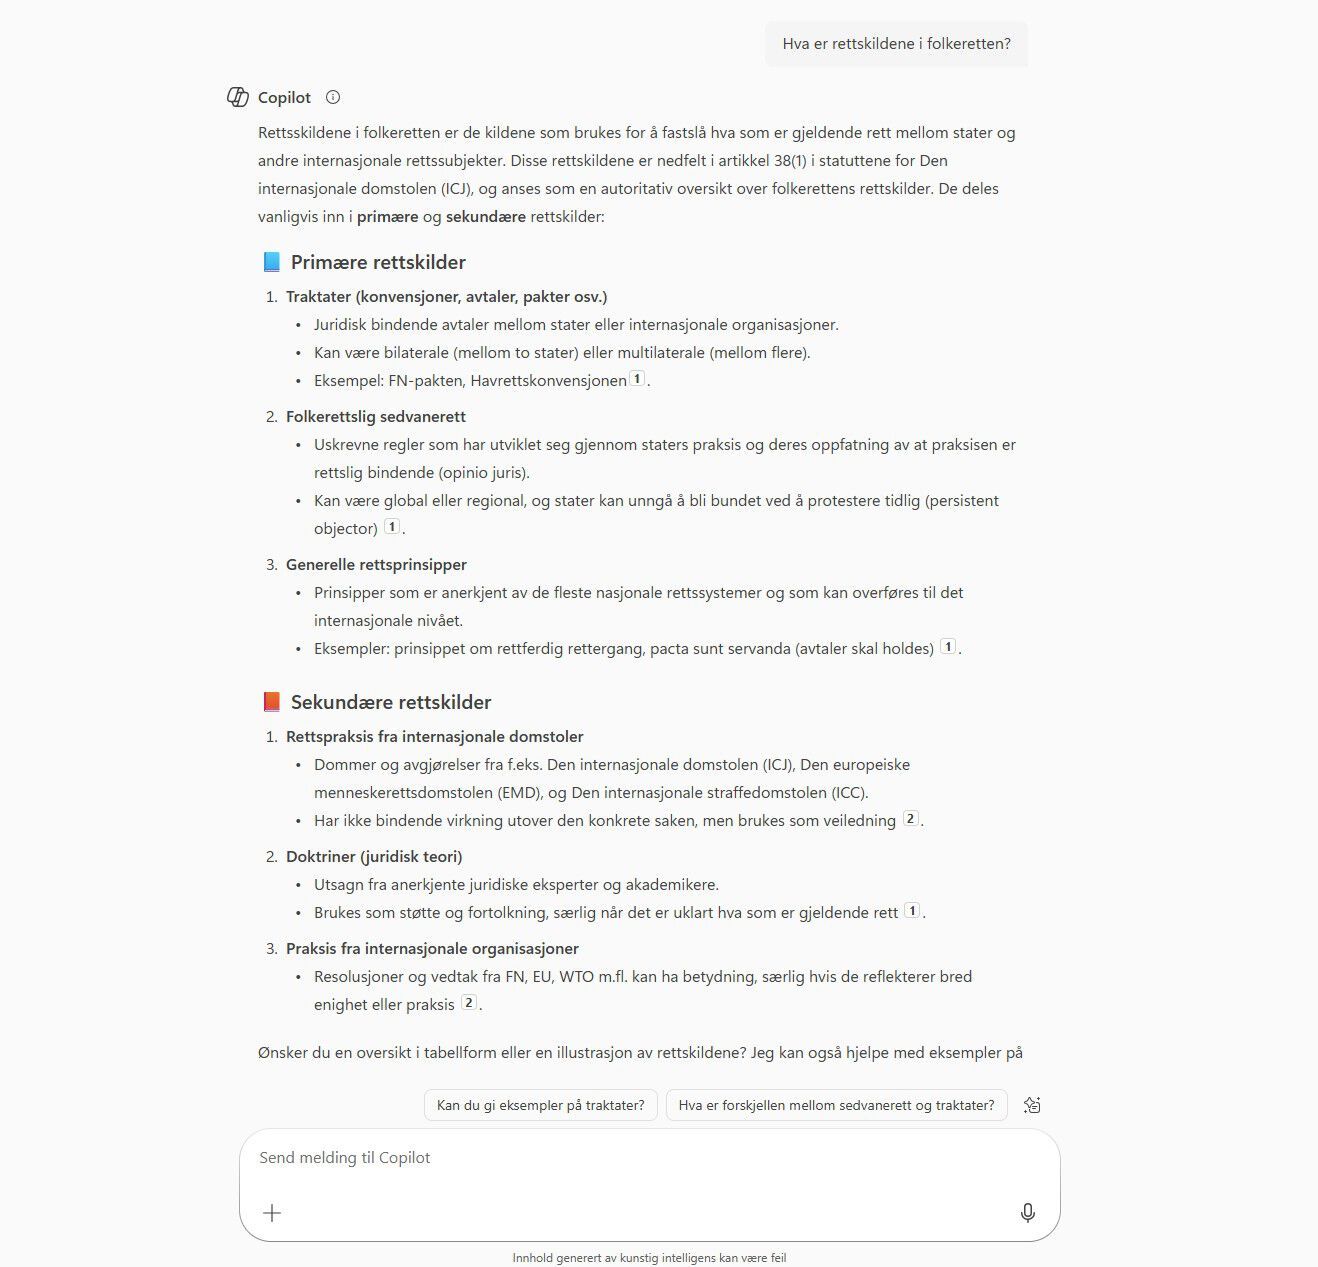
Da vi spurte CoPilot "Hva er rettskildene i folkeretten?" genererte den en tekst som minner litt om en leksikonartikkel. Teksten inneholder to klikkbare fotnoter. Den ene viser til Store Norske Leksikons artikkel om folkerett, og den andre viser til Juridisk biblioteks rettskildeguide til internasjonale rettskilder. Teksten har også en kildeliste, der du kan se hvilke andre kilder svaret bygger på. Det inkluderer innhold fra Stortinget.no, Regjeringen.no og FN.no, men også de publiserte studienotatene til en student (!).
Lovdatas KI-søk
Lovdatas nye KI-søk er en del av Lovdata Pro 2, som ble lansert sommeren 2025. Som jusstudent ved UiO har du tilgang på verktøyet gjennom Lovdata Pro. Merk deg at Lovdata Pro 2 ikke er godkjent hjelpemiddel på eksamen.
Lovdatas KI-søk bygger på en RAG-modell. Når du skriver en instruks vil modellen først søke etter relevante relevante rettskilder i Lovdata Pros egne databaser, slik som norske lover, forarbeider og rettsavgjørelser. Deretter vil modellen generere et svar basert på rettskildene den har funnet. Svaret inkluderer en sammenstilling og et kildegrunnlag.
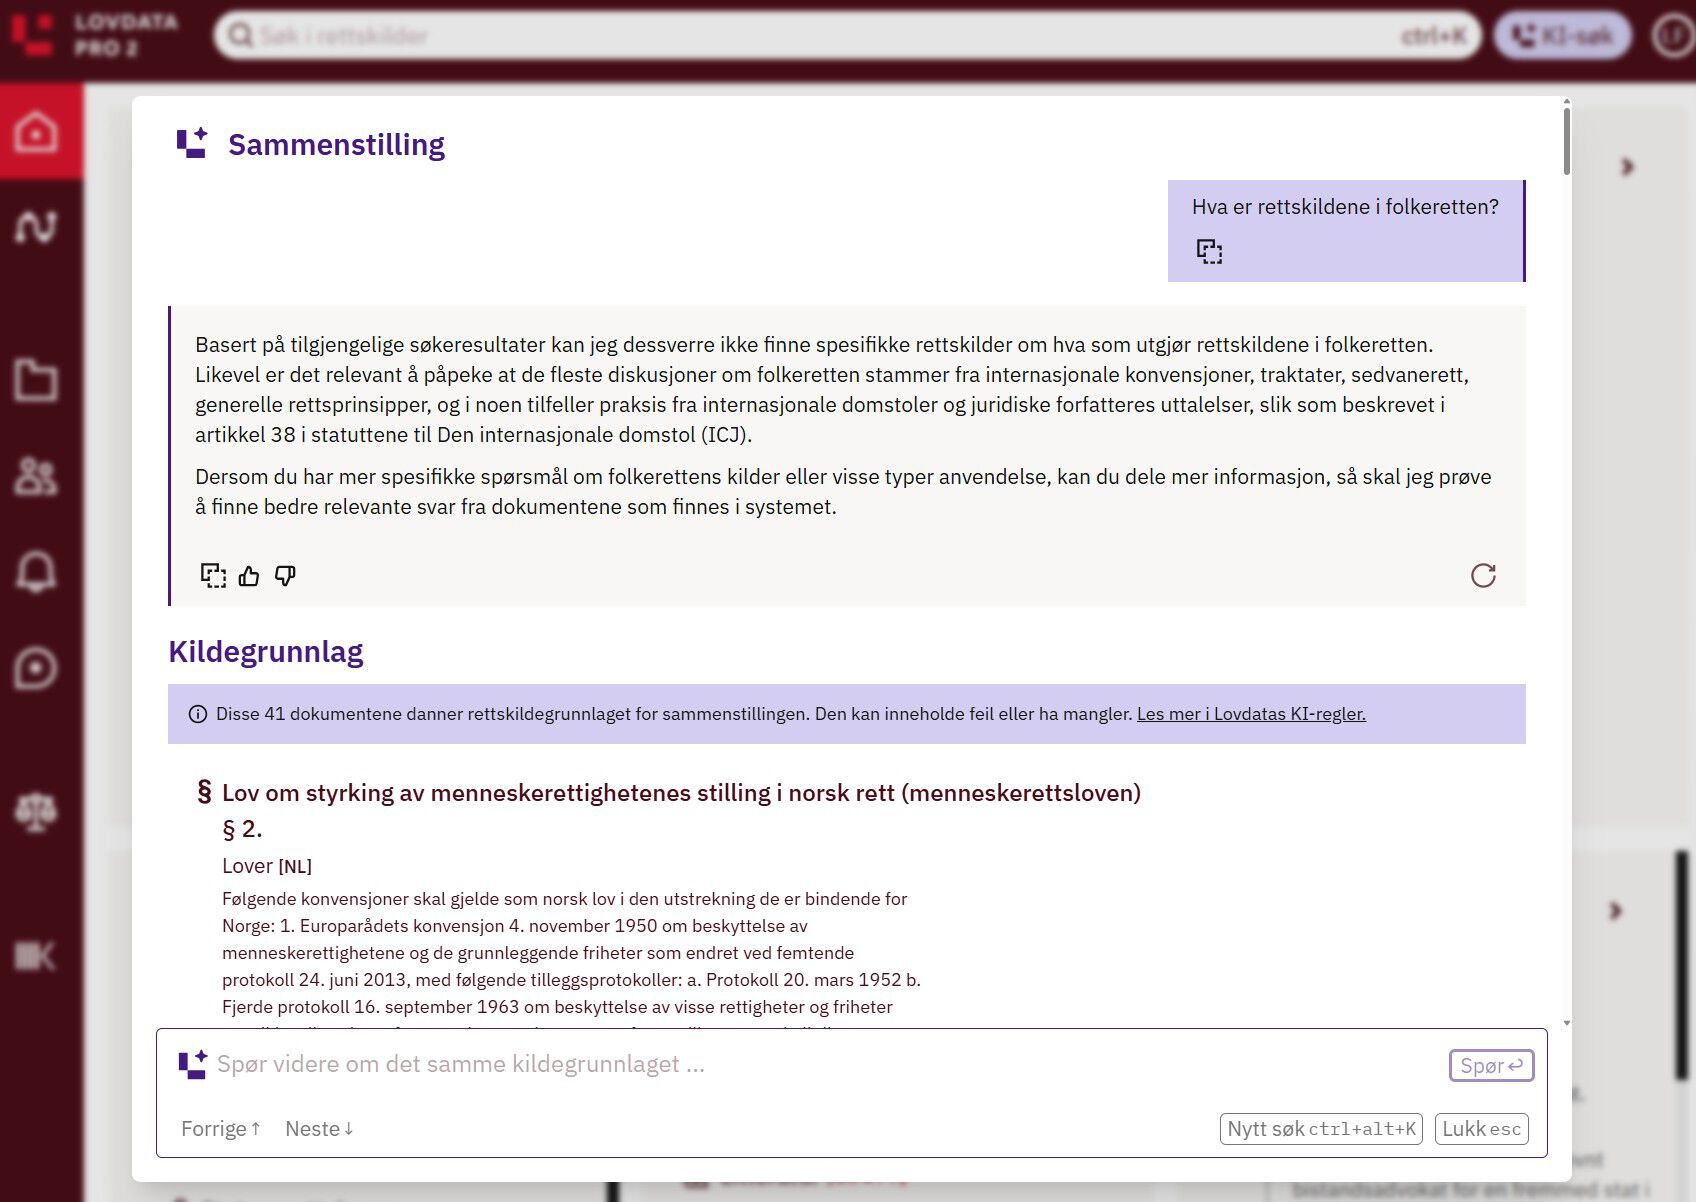
Da vi spurte Lovdata KI-søk om "Hva er rettskildene i folkeretten?" genererte modellen et svar bestående av en sammenstilling og et kildegrunnlag. I sammenstillingen på to avsnitt forklarer modellen i en unnskyldende tone at den ikke fant tilstrekkelig med rettskilder til å svare på spørsmålet. I kildegrunnlaget lister modellen opp 41 rettskilder som dannet grunnlaget for sammenstillingen. Det knappe svaret skyldes at Lovdata KI-søk foreløpig kun er programmert til å svare på spørsmål rettet mot norske rettsforhold.
4. Gode råd om bruk av KI-verktøy
Før du tar i bruk et nytt KI-verktøy, så gjør deg kjent med hvordan verktøyet fungerer: hva slags språkmodell bygger det på, hva slags treningsmateriale er språkmodellen trent på, og hvilke begrensninger må du være klar over.
Bruk gjerne KI-verktøy som et hjelpemiddel for å sette deg inn i et juridisk spørsmål eller tema, men ikke stans der. Du bør alltid undersøke kvalitetssikret juridisk litteratur, slik som lærebøker, vitenskapelige artikler og fagbøker, for å få en faglig trygg forståelse av temaet.
Husk at KI-verktøy ikke anvender juridisk metode, men genererer tekster basert på sannsynlighetsberegninger - altså hva som statistisk sett virker som et relevant svar. Dette kan føre til hallusinasjoner, det vil si generere oppdiktede opplysninger, sitater og kildehenvisninger.
Husk derfor alltid å kvalitetssikre innhold generert av KI-verktøy. Det gjør du ved å verifisere informasjonen opp mot pålitelige kilder. Finn primærkildene i autorative baser (som Lovdata, HUDOC, FNs traktatbase, osv.), og sjekk hva som faktisk står i teksten.
5. Kilder / Videre lesning
Vitenskapelige artikler
Dahl, M., Varun Magesh, Mirac Suzgun, og Daniel E. Ho. “Large Legal Fictions: Profiling Legal Hallucinations in Large Language Models.” Journal of Legal Analaysis, årg. 16 nr. 1 (2024), s. 64–93. DOI: https://doi.org/10.1093/jla/laae003
Farsethås, Hans Christian. "ChatGPT og juridiske tekster". Lov og rett (2023) årg. 62 nr. 5, s. 281-302. DOI: https://www.scup.com/doi/10.18261/lor.62.5.3
Magesh, Varun, Faiz Surani, Matthew Dahl, m.fl. "Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools". Journal of Empirical Legal Studies, årg. 22 (2025), s. 216-242. DOI: https://doi.org/10.1111/jels.12413
Avisartikler
Fosaas, Jonas. "Schjødt deler egne KI-retningslinjer: - Et så sterkt verktøy krever klare rammer". Advokatbladet, 16. juni 2025.
Robertsen, Maria Øyvindsdatter. "Høyesterett har mottatt sitt første prosesskriv med oppdiktede kilder". Advokatbladet, 10. april 2025.
Schmidt, Nina. "Lovdata har lansert nytt KI-vertkøy for profesjonelle brukere". Advokatbladet, 19. juni 2025.
Retningslinjer
Høyesterett. Advokatveiledning: Anke, saksforberedelse og prosedyre for Høyesterett, oppdatert april 2025. Oslo: Høyesterett, 2025.
Universitetet i Oslo. "Hvordan bruke KI som student." (u.å). hentet 08.08.2025